Besoin d'aide ?
Contactez-nous
Nous aidons les entreprises de toutes tailles à fiabiliser leur tracking et leur conformité RGPD.


Nous aidons les entreprises de toutes tailles à fiabiliser leur tracking et leur conformité RGPD.
Nous aidons les entreprises de toutes tailles à fiabiliser leur tracking et leur conformité RGPD.
Avec le Google Consent Mode en mode avancé, GA4 complète les visiteurs qui refusent les cookies par de la modélisation. Cette estimation est utile pour évaluer un volume total, mais elle peut inverser une tendance d'une année sur l'autre, surtout après un changement de bannière. Pour piloter une évolution, comparez des données non modélisées.
Les conclusions à retenir avant de comparer deux périodes dans GA4.
Le Google Consent Mode transmet aux balises Google le choix de chaque visiteur face à la bannière cookies. En mode avancé, quand un visiteur refuse, GA4 reçoit quand même des signaux sans cookie. À partir de ces signaux, Google estime le comportement des visiteurs qui ont refusé : c'est la modélisation comportementale.
Google décrit le principe ainsi dans sa documentation sur la modélisation comportementale : le modèle estime le comportement des utilisateurs qui refusent les cookies analytiques en se basant sur celui des utilisateurs similaires qui les acceptent.
Trois conditions encadrent cette modélisation, et elles comptent pour la suite :
analytics_storage refusé pendant au moins 7 jours, et au moins 1 000 utilisateurs par jour avec analytics_storage accepté pendant au moins 7 des 28 jours précédents.Ce dernier point suffit à expliquer pourquoi deux sources qui partent de la même collecte peuvent diverger. La question qui nous intéresse ici est plus gênante : comment elles peuvent afficher des tendances opposées.
Un de nos clients, une organisation multi-entités, suit son trafic dans GA4 avec la modélisation du consentement activée. En parallèle, ses données GA4 sont exportées dans BigQuery, et un outil de mesure d'audience configuré sans consentement tourne sur un site de comparaison.
Environ un an plus tôt, la bannière cookies avait changé. L'ancienne version rendait le refus difficile : il fallait ouvrir les paramètres et tout décocher. La nouvelle, conforme aux recommandations de la CNIL, propose un vrai choix avant la navigation, avec un « continuer sans accepter » visible.
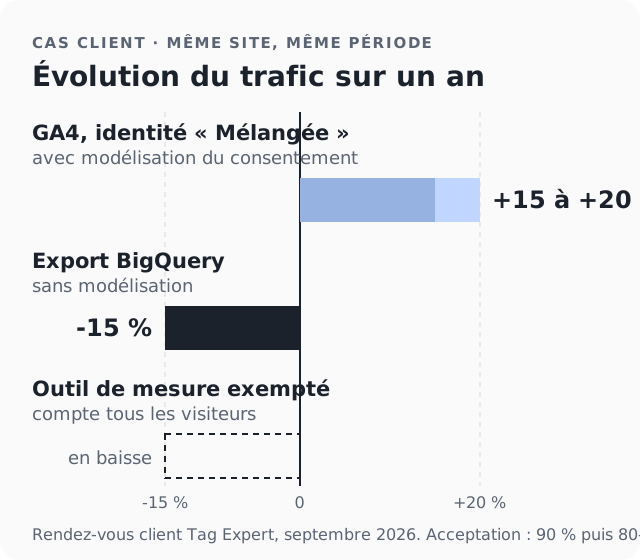
Le taux d'acceptation a peu bougé, passant d'environ 90 % à 80-85 %. Pourtant, sur la comparaison d'une année sur l'autre, les sources se contredisaient :
| Source | Modélisation du consentement | Tendance du trafic sur un an |
|---|---|---|
| GA4, interface standard (identité « Mélangée ») | Oui | Hausse d'environ 15 à 20 % |
| Export BigQuery des données GA4 | Non | Baisse d'environ 15 % |
| Outil de mesure d'audience sans consentement | Sans objet (mesure exemptée) | Baisse, dans le même sens que BigQuery |
Côté client, le problème a été résumé en une phrase : entre moins 15 et plus 15 % d'utilisateurs, l'analyse n'est clairement pas la même. Il fallait communiquer une tendance aux équipes métier, et les deux chiffres menaient à des décisions opposées.
La question posée était légitime : « L'année dernière, on n'avait pas besoin de modéliser puisqu'on avait la donnée, et pourtant on n'avait pas un tel écart. » C'est précisément ce qu'aucun des articles que nous avons lus sur le Consent Mode n'aborde. Ils expliquent la configuration, la différence entre mode basique et mode avancé, les paramètres de la v2, mais jamais ce que la modélisation fait aux comparaisons dans le temps.
Une comparaison d'une année sur l'autre n'a de sens que si les deux périodes sont mesurées de la même façon. Avec la modélisation du consentement, ce n'est plus garanti. Voici les trois mécanismes à vérifier, du plus fréquent au plus subtil.
La modélisation ne s'active qu'au-delà des seuils décrits plus haut. C'est une hypothèse à vérifier propriété par propriété, pas une règle générale : sur un site où 90 % des visiteurs acceptent, le volume d'événements refusés peut rester sous le seuil de 1 000 par jour. Si le refus devient plus visible et que ce volume franchit le seuil, la modélisation démarre. La période récente est alors complétée par des estimations, la période de l'an passé ne l'est pas, et la hausse affichée peut venir en partie de ce complément plutôt que d'un trafic réellement plus élevé. Pour le vérifier, comparez les deux périodes en identité « Observée » (étape 2 de la méthode ci-dessous).
Le modèle suppose que ceux qui refusent se comportent comme des visiteurs similaires qui acceptent. Quand le refus était caché, seuls les visiteurs les plus déterminés refusaient. Quand il devient aussi simple qu'accepter, le profil des personnes qui refusent change. Le modèle, lui, continue d'extrapoler à partir des visiteurs consentants. Plus l'écart de profil est grand, plus l'estimation s'éloigne de la réalité.
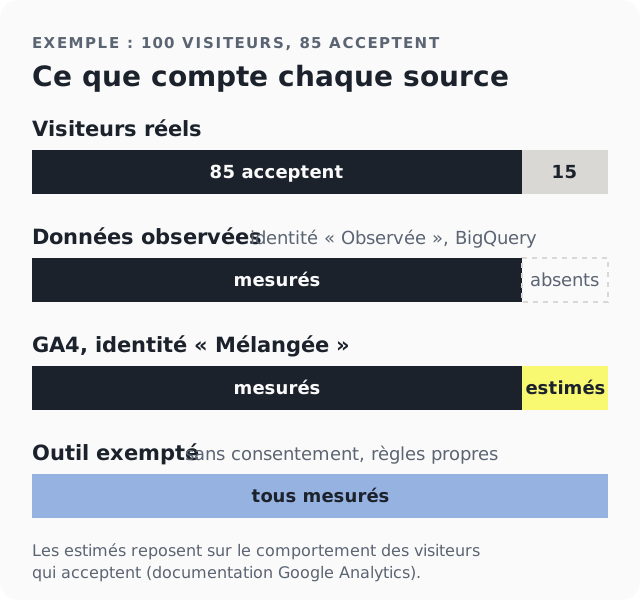
L'export BigQuery ne contient pas les données modélisées. Un outil de mesure configuré pour être exempté de consentement, dans les conditions décrites par la CNIL pour les outils de mesure d'audience, mesure tous les visiteurs, mais avec des règles de sessions et de filtrage qui lui sont propres. Comparer des volumes absolus entre ces sources n'a donc pas de sens. Comparer leurs tendances en a, et c'est là que le désaccord devient un signal.
Voici la procédure que nous appliquons quand deux sources donnent des tendances opposées.
La modélisation n'est pas « fausse ». Elle répond à une question différente : estimer le volume total de visiteurs, y compris ceux qui refusent. Elle devient trompeuse quand on l'utilise pour une question qu'elle ne sait pas traiter, comme une évolution dans le temps à travers un changement de bannière.
| Question que vous vous posez | Source recommandée | Pourquoi |
|---|---|---|
| Le trafic progresse-t-il d'une année sur l'autre ? | Un outil exempté de consentement, sinon les données non modélisées corrigées de l'évolution du taux de consentement | Même méthode de mesure sur les deux périodes |
| Combien de visiteurs au total, refus compris ? | GA4 en identité « Mélangée » | C'est la raison d'être de la modélisation |
| Quelle campagne génère des ventes ? | Données de conversion recoupées avec le back-office | Les ventes réelles restent la référence finale |
| Mon changement de bannière a-t-il un impact ? | Taux de consentement de la CMP + données observées | Isole l'effet du consentement de celui du trafic |
Une précision importante sur les données non modélisées : elles ne comptent que les visiteurs qui acceptent. Si le taux de consentement passe de 90 % à 80 %, elles baissent mécaniquement d'environ 11 %, même à trafic constant (80 divisé par 90). Pour lire une tendance, corrigez-les de l'évolution du taux de consentement, ou appuyez-vous sur un outil exempté, qui ne dépend pas du choix du visiteur. Dans notre cas, l'outil exempté allait dans le même sens que BigQuery, ce qui plaide pour une baisse réelle du trafic.
Dans le cas décrit plus haut, l'équipe a retenu la donnée non modélisée de BigQuery comme référence pour communiquer les tendances en interne, et a construit un reporting automatique sur cette base. GA4 en identité « Mélangée » reste utile pour estimer des volumes globaux, mais plus pour piloter une évolution.
Si vos écarts portent sur les ventes plutôt que sur le trafic, c'est un autre diagnostic, que nous menons dans le cadre de notre audit de fiabilité du tracking.
Trois chantiers évitent de revivre ce type de situation.
Pour voir concrètement comment le Consent Mode se configure dans Google Tag Manager avec une CMP, étape par étape, notre vidéo tutoriel :
 Vidéo Tag Expert · 15:26Comment configurer le consent Mode avec OneTrust & GTM (RGPD + Bing Ads)Regarder sur YouTube
La documentation technique de Google sur la configuration du mode Consentement reste la référence pour les paramètres eux-mêmes. Ce qu'elle ne dit pas, c'est comment lire vos rapports une fois la modélisation active : c'est là que se jouent les mauvaises décisions.
Vous constatez un écart de tendance que vous n'arrivez pas à expliquer ? Nous pouvons regarder votre configuration avec vous lors d'un échange de 30 minutes.
Non. Google indique que les données modélisées ne sont pas disponibles dans l'export BigQuery. BigQuery contient uniquement les événements réellement collectés, ce qui en fait une bonne référence pour comparer des périodes entre elles.
Dans Administration, puis Affichage des données, puis Identité pour le reporting, choisissez « Observée ». Ce réglage ne modifie ni la collecte ni le traitement des données, et vous pouvez revenir à « Mélangée » à tout moment.
La propriété doit envoyer au moins 1 000 événements par jour avec le consentement analytics refusé pendant 7 jours, et au moins 1 000 utilisateurs par jour ayant accepté sur 7 des 28 jours précédents. Le modèle peut ensuite demander plus de 7 jours d'entraînement.
Elle est conçue pour estimer un volume total de visiteurs, refus compris. Elle devient trompeuse pour analyser une évolution dans le temps, en particulier quand la bannière ou le taux de consentement a changé entre les deux périodes comparées.
Nous auditons votre configuration du Consent Mode, votre bannière et vos sources de données pour que chaque rapport annonce clairement ce qu'il mesure. Un échange de 30 minutes suffit pour savoir si vos tendances sont fiables.
Discuter avec un expert